引言
在数据成为核心生产要素的今天,企业面对的数据量、数据种类和数据处理时效性要求都在快速增长。如何构建一套既能支撑海量数据存储与计算,又能为上层业务提供稳定、高效、可复用的数据处理服务,已经成为大数据架构设计的核心命题。本文围绕“大数据架构图设计”展开,重点讨论数据处理服务的分层设计、关键组件、数据流和工作机制,给出一套可落地、可扩展的架构思路。
一、总体架构设计原则
高效的大数据架构通常不是单一技术的堆叠,而是围绕业务目标、数据特征和成本约束进行的体系化设计。核心设计原则包括:
- 分层解耦:采集、存储、计算、服务、应用各层职责清晰,降低系统耦合度。
- 批流一体:同时支持批量数据处理和实时流处理,满足离线分析与实时决策两类场景。
- 弹性扩展:计算与存储资源可按需伸缩,适应数据量和并发量的波动。
- 数据治理内建:元数据、质量、安全、血缘和权限管理贯穿全生命周期。
- 服务化输出:通过统一的数据处理服务屏蔽底层复杂性,让业务方以API、SQL或任务编排方式使用数据能力。
二、大数据架构分层图
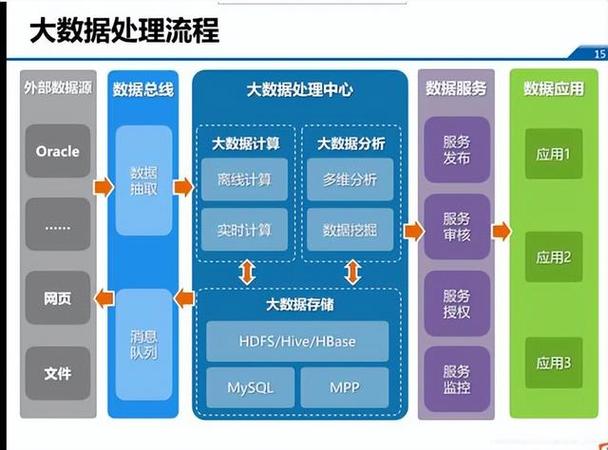
一个典型的大数据处理系统可以划分为六层:
1. 数据源层
- 业务数据库(MySQL、PostgreSQL、Oracle)
- 日志系统(Nginx日志、应用日志、埋点日志)
- 消息队列(Kafka、Pulsar、RocketMQ)
- 物联网设备与外部数据接口(API、SFTP、爬虫合规数据源)
2. 数据采集与同步层
- 批量采集:Sqoop、DataX、Flink CDC、Canal
- 实时采集:Kafka Connect、Flume、Logstash、Fluentd
- 文件同步:对象存储、FTP、HDFS
3. 数据存储层
- 分布式文件系统:HDFS、对象存储(S3、OSS、COS)
- 湖仓存储:Hudi、Iceberg、Delta Lake
- NoSQL:HBase、Cassandra、Redis
- 数仓:Hive、ClickHouse、Doris、StarRocks、Greenplum
- 消息缓冲:Kafka、Pulsar
4. 数据计算层
- 批处理:MapReduce、Spark、Tez
- 流处理:Flink、Spark Streaming、Storm
- 交互式分析:Presto、Impala、ClickHouse
- 机器学习:Spark MLlib、TensorFlow、PyTorch
- 任务调度:Airflow、DolphinScheduler、Azkaban
5. 数据处理服务层
- 数据开发平台:Notebook、SQL Studio、低代码任务编排
- 数据服务API:统一查询网关、指标服务、标签服务
- 数据质量服务:规则引擎、质量报告、自动告警
- 元数据与血缘服务:Atlas、DataHub、Amundsen
- 安全与权限服务:Kerberos、Ranger、Sentry、数据脱敏
6. 数据应用层
- BI报表与可视化:Tableau、Superset、FineBI
- 实时大屏与风控:Flink SQL、CEP
- 推荐与画像:特征平台、用户标签体系
- AI平台:特征工程、模型训练、在线推理
这三层到六层之间的数据流向通常是:数据源 → 采集 → 存储 → 计算 → 服务 → 应用,并伴随监控、治理和安全能力的横向贯穿。
三、数据处理服务的核心能力
“数据处理服务”是大数据架构中最贴近业务的一层。它不是单一的ETL工具,而是一组面向数据开发、数据分析和数据应用的能力集合。核心包括:
- 数据集成服务:支持多源异构数据的批量抽取、实时同步、增量订阅和全量迁移。
- 数据开发服务:提供SQL、Python、Java等多种开发方式,支持工作流编排、依赖调度、版本管理和上线发布。
- 数据计算服务:将批处理、流处理和交互式查询封装为可调用的计算任务,按需分配资源。
- 数据服务API:把结果表、指标、标签发布为HTTP API或RPC服务,并对接网关进行鉴权、限流和审计。
- 数据质量服务:对数据的完整性、准确性、一致性、及时性、唯一性进行监控与校验。
- 元数据与血缘服务:自动采集技术元数据、业务元数据,跟踪表级和字段级血缘,辅助影响分析和问题定位。
- 安全治理服务:包括认证、授权、审计、脱敏、加密和隐私计算。
这些服务共同构成统一的数据处理平台,业务方不必关心底层是Spark还是Flink,只需通过清晰的服务接口获取可信数据。
四、典型数据处理流程
以一个电商场景为例:
- 离线链路:业务库Binlog通过Canal进入Kafka,再由Flink CDC写入Hudi/Iceberg湖仓;凌晨通过Spark SQL进行清洗、维度关联、聚合,生成DWD、DWS、ADS层表;ADS结果同步至ClickHouse/Doris供BI查询。
- 实时链路:用户行为日志通过Kafka接入Flink,在流中完成会话切分、实时指标计算、异常检测,写入Redis和ClickHouse,驱动实时大屏、推荐和风控。
- 服务化链路:实时与离线结果通过统一数据服务API发布,供推荐系统、搜索系统、CRM和运营平台调用。
该模式的重要性在于:批流共享同一套元数据、权限和服务输出规范,从而降低开发与运维成本,提高数据一致性和时效性。
五、关键技术选型与考量
- 存储格式:优先选择列式存储(Parquet、ORC)和开放表格式(Hudi、Iceberg),便于schema演进和增量读写。
- 计算引擎:Spark适合大规模批处理,Flink适合低延迟流处理,ClickHouse/Doris适合OLAP。避免单一引擎包打天下。
- 调度与编排:DolphinScheduler和Airflow生态成熟,结合Kubernetes可实现任务级别的弹性伸缩。
- 数据湖仓一体:通过Iceberg/Hudi/Delta实现“湖存储+仓体验”,同时支持批流读写与ACID。
- 可观测性:必须把Metrics、Logging、Tracing和血缘统一考虑,否则排障成本会急剧上升。
- 成本优化:分层存储、冷热分离、压缩与生命周期策略是降低大数据总拥有成本的必要手段。
六、架构演进建议
1. 阶段一:以离线数仓为主,构建稳定的采集、存储和调度体系,解决“看得见数据”的问题。
2. 阶段二:引入实时链路和湖仓一体,提高时效性与灵活性。
3. 阶段三:建设指标中台、标签平台和数据服务API,让数据从“可查”走向“可用”。
4. 阶段四:加入数据产品与智能应用,推动数据在推荐、运营、风控和AIGC等场景中产生业务价值。
数据治理应从项目初期就介入,而不是系统膨胀后再补救。
##
大数据架构图设计的关键,不只是画出完整的组件连接图,而是回答“数据从哪里来、以什么方式处理、怎样安全高效地服务业务”这几个根本问题。以分层解耦、批流一体、数据治理和服务化为核心,通过统一的数据处理服务层向上支撑多样化的应用,是构建高效数据处理系统的可行路径。体系化设计和持续演进,远比依赖单点技术爆发力更具长期价值。